وهم التوسع وصعود منافس صغير
نموذج تكراري بـ7 ملايين معامل فقط حقق في معيار الاستدلال ARC-AGI-1 نتيجة أعلى من عدة نماذج لغوية أكبر منه بكثير، منها Gemini 2.5 Pro وo3-mini-high وDeepSeek R1 ذو الـ671 مليار معامل. وقبله بأشهر حقق سلفه HRM، بـ27 مليون معامل، نتيجة مشابهة. هذا لا يعني أن النماذج الصغيرة تتفوق على الكبيرة في كل شيء. لكنه يبيّن أن السماح لشبكة صغيرة بالعودة إلى إجابتها مرة بعد مرة يهم في هذا النوع من الألغاز الشبكية أكثر من عدد المعاملات، وبجزء يسير من التكلفة الحسابية.
يروي هذا المقال قصة ظهور النماذج التكرارية الصغيرة التي غيّرت قواعد اللعبة.
بينما تكافح النماذج اللغوية الكبيرة (LLMs) مع الألغاز المنطقية التي نسمّيها معايير AGI، ظهرت فكرة جديدة ورائعة ضد «فيروس التوسع» هذا. الفكرة بسيطة: ماذا لو، بدلاً من تكبير دماغ النموذج، سمحنا له بالتفكير قبل الإجابة وتحسين استجابته؟
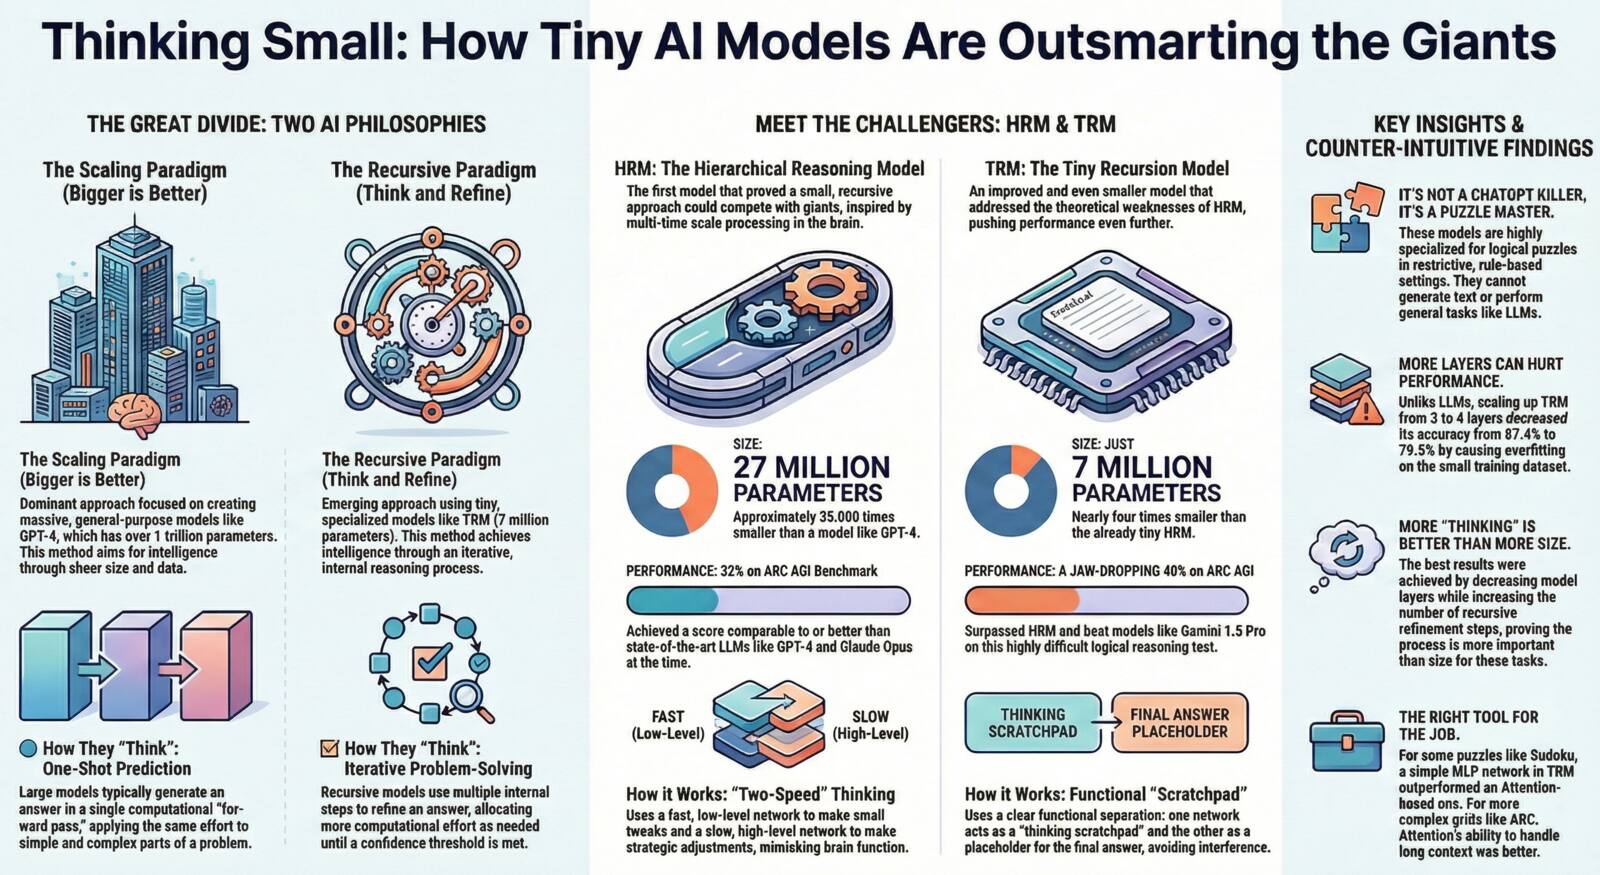
أدّت هذه الفكرة إلى HRM (نموذج الاستدلال الهرمي) الذي نشرته شركة Sapient Intelligence في يونيو 2025 (arXiv 2506.21734). يضم النموذج 27 مليون معامل، ودُرّب على نحو 1000 مثال فقط دون تدريب مسبق على نصوص الإنترنت. تذكر ورقة HRM نتيجة 40.3% في ARC-AGI-1 و5.0% في ARC-AGI-2، متقدمًا في ARC-AGI-1 على o3-mini-high (34.5%) وClaude 3.7 8K (21.2%). هذه نتائج على مجموعة التقييم العامة. وعندما أعاد فريق ARC Prize اختبار HRM على المجموعة المخفية شبه الخاصة (semi-private)، سجّل 32% في ARC-AGI-1 و2% في ARC-AGI-2 (تحليل ARC Prize). ووجد التحليل نفسه أن التصميم «الهرمي» ذا المستويين لم يضف الكثير مقارنة بمحوّل عادي بالحجم نفسه، وأن معظم المكسب جاء من حلقة التحسين الخارجية.
كيف يعمل نموذج HRM؟ (سر التفكير البطيء والسريع)
الفرق الجوهري أن النماذج اللغوية العادية تحاول التنبؤ بكل شيء في «تمريرة أمامية» واحدة. هذا يعني أن الجهد الذي تبذله لحساب «1+1» يساوي الجهد لمشكلة معقدة.
لكن نموذج HRM مستوحى من بنية الدماغ البشري. يتكون هذا النموذج من شبكتي محول صغيرتين تعملان بسرعتين مختلفتين:
- شبكة منخفضة المستوى (سريعة): تُجري تغييرات سريعة وتدريجية على «مسودة» ذهنية.
- شبكة عالية المستوى (بطيئة): تحدد الاستراتيجية العامة وتقرر ما إذا كانت الإجابة جاهزة أم تحتاج مزيدًا من التفكير.
بدلاً من الاستجابات الفورية، يفكّر هذا النموذج تكراريًا ويحسّن إجابته عدة مرات حتى يصل للنتيجة الصحيحة.
نموذج TRM: عندما يصبح «الصغير» أصغر!
جاء بعده نموذج أبسط هو TRM (النموذج التكراري المتناهي الصغر)، قدّمته الباحثة Alexia Jolicoeur-Martineau من Samsung SAIL Montréal في أكتوبر 2025 (arXiv 2510.04871). يتخلى TRM عن الافتراضات البيولوجية في HRM، ويستخدم شبكة صغيرة واحدة، ويغيّر طريقة التدريب. وبـ7 ملايين معامل، أي نحو ربع حجم HRM، يحقق نتيجة أعلى.
تذكر ورقة TRM نتيجة 44.6% في ARC-AGI-1 و7.8% في ARC-AGI-2 (تُقرَّب عادة إلى 45% و8%). وفي الجدول نفسه يحصل Gemini 2.5 Pro على 37.0% و4.9%، وo3-mini-high على 34.5% و3.0%، وDeepSeek R1 على 15.8% و1.3%. لكن TRM لا يتفوق على الجميع: Grok-4-thinking يسجل 66.7% و16.0%. أما إعادة الاختبار المستقلة من ARC Prize على المجموعة شبه الخاصة فسجّلت 40% في ARC-AGI-1 و6.2% في ARC-AGI-2 (نتائج ARC Prize). ولا يظهر GPT-4 ولا GPT-5 في جدول المقارنة في أيٍّ من الورقتين.
لماذا كان TRM أكثر نجاحًا؟
بدلاً من محاكاة دماغ الفأر (كما فعل HRM)، ركّز نموذج TRM على فصل وظيفي:
- مساحة لـمسودة التفكير.
- مساحة لـحاوية الإجابة.
بدلاً من افتراض وصوله لـ«توازن» (وهو خطأ ارتكبه HRM)، يتدرب هذا النموذج بالضبط على الحلقات التي ينفّذها. النقطة الأكثر إثارة أنه عندما حاول الباحثون زيادة طبقات النموذج، انخفض أداؤه. في الواقع، منع حجم النموذج الصغير «الإفراط في التخصيص (Overfitting)» على بيانات محدودة وساعده على التعميم بشكل أفضل.
تشبيه لفهم أفضل
تخيّل أنك تطلب من شخصين رسم لوحة معقدة.
الشخص الأول (نموذج لغوي كبير): عبقري يجب أن يكمل اللوحة بـضربة قلم واحدة دون رفع يده عن الورقة. مهما كان عبقريًا، احتمال الخطأ مرتفع.
الشخص الثاني (TRM): رسام عادي، لكن يُسمح له برسم مسودة أولية، والنظر إليها، والمحو، والتصحيح، والعمل على التفاصيل لساعات حتى يرضى عن النتيجة.
في المشكلات المنطقية والمعقدة، غالبًا ما يفوز الرسام الثاني (النموذج التكراري الصغير) لأن لديه فرصة التفكير والتصحيح، حتى لو كان دماغه (معاملاته) أصغر.
ماذا حدث بعد ذلك: جائزة ARC Prize 2025
لم يبقَ TRM مجرد فضول علمي. ففي نتائج ARC Prize 2025 المنشورة في 5 ديسمبر 2025، فازت ورقة "Less is More: Recursive Reasoning with Tiny Networks" بالمركز الأول في جوائز الأوراق البحثية وبجائزتها البالغة 50,000 دولار. ويذكره تحليل النتائج مثالًا على شبكات صغيرة جدًا قياسًا بأدائها في ARC-AGI، يجري تدريبها الخاص بكل مهمة وقت الاختبار.
وظهرت الفكرة أيضًا في نتائج المسابقة. فقد وصل المركز الأول في Kaggle، فريق NVARC، إلى 24.0% في التقييم الخاص لـ ARC-AGI-2 بمجموعة نماذج تضمنت مكونات مبنية على TRM، واستخدم فريق ARChitects في المركز الثاني (16.5%) التحسين التكراري للإجابة فوق نموذج لغوي من نوع diffusion. لا أحد منهما نموذج بـ7 ملايين معامل وحده، لكن كليهما استعار الحلقة التي أنجحت TRM.
الخاتمة: مستقبل الذكاء الاصطناعي تكراري
أثبت هذا البحث أن حل المشكلات المنطقية الصعبة ليس حكرًا على النماذج اللغوية العملاقة. يمكن للنماذج الصغيرة ذات قدرة التفكير التكراري (Recursion) حل مشكلات لا تستطيع النماذج الكبيرة معالجتها بتمريرة معالجة واحدة.
بدلاً من حفظ البيانات، تتعلم هذه النماذج كيفية تحرير لوحة عمل (Canvas) عبر خطوات متعددة حتى تصل للإجابة الصحيحة.
أهم استنتاجات هذا البحث:
- الأكبر ليس دائمًا أفضل - البنية وطريقة التفكير تهمان أكثر من الحجم
- القدرة على المراجعة والتحسين يمكن أن تحل محل مليارات المعاملات
- الاستلهام من الدماغ البشري (التفكير السريع والبطيء) يمكن أن يؤدي لنماذج أكثر كفاءة
- يمكن للنماذج الأصغر التعميم بشكل أفضل وهي أقل عرضة للإفراط في التخصيص
ربما يكمن مستقبل الذكاء الاصطناعي ليس في نماذج بتريليونات المعاملات، بل في نماذج ذكية تعرف كيف «تفكّر».
هذا هو الرهان ذاته الذي يخوضه FanMind على نطاق أصغر: مساعد أضيق نطاقاً وملزَم بالاستشهاد يفضّل الرفض على التخمين، يتفوّق على مساعد أوسع يجيب عن كل شيء بسلاسة لكن ليس دائماً بشكل صحيح. تعرّف كيف ينطبق ذلك على مساعد تنظيمي داخلي.
الأسئلة الشائعة
ما هو النموذج التكراري الصغير (TRM)؟
TRM نموذج بسبعة ملايين معامل نشرته ألكسيا جوليكور-مارتينو في Samsung SAIL مونتريال في أكتوبر 2025. يستخدم شبكة صغيرة واحدة تعود إلى إجابتها عدة مرات، فتحسّن مسودة التفكير وموضع الإجابة، بدلاً من توقع النتيجة في تمريرة واحدة. وقد جاء بعد نموذج HRM ذي 27 مليون معامل من Sapient Intelligence.
كم يسجّل TRM في ARC-AGI مقارنة بالنماذج اللغوية الكبيرة؟
تذكر ورقة TRM نسبة 44.6% في ARC-AGI-1 و7.8% في ARC-AGI-2، مقابل 37.0% و4.9% لـ Gemini 2.5 Pro و15.8% و1.3% لـ DeepSeek R1. وقاس اختبار ARC Prize المستقل على المجموعة شبه الخاصة 40% و6.2%. ويظل Grok-4-thinking أعلى بنسبة 66.7% و16.0%.
هل تتفوق النماذج التكرارية الصغيرة على GPT-4؟
هذا الادعاء غير مدعوم. لا يظهر GPT-4 ولا GPT-5 في جداول المقارنة في ورقتي HRM وTRM. ما تُظهره الورقتان أضيق: في ألغاز الشبكات في ARC-AGI، يتفوق نموذج صغير يحسّن إجابته عبر عدة دورات على عدة نماذج لغوية أكبر بكثير، بجزء ضئيل من الحوسبة.
ما الفرق بين HRM وTRM؟
يستخدم HRM شبكتي محوّل صغيرتين تعملان بسرعتين مختلفتين، واحدة سريعة منخفضة المستوى وأخرى بطيئة عالية المستوى، استلهاماً من الدماغ. أما TRM فيتخلى عن هذه الافتراضات البيولوجية، ويستخدم شبكة واحدة، ويتدرّب على الحلقات نفسها التي ينفذها. ووجدت ARC Prize أن معظم مكسب HRM جاء من حلقة التحسين الخارجية لا من التسلسل الهرمي.
هل فاز TRM بجائزة ARC Prize؟
فاز بالجائزة الأولى للأوراق البحثية. ففي ARC Prize 2025 نالت ورقة "Less is More: Recursive Reasoning with Tiny Networks" لأليكسيا جوليكور-مارتينو المركز الأول في جوائز الأوراق بقيمة 50,000 دولار. أما جائزة النتيجة فمنفصلة وذهبت إلى NVARC.
من فاز في ARC Prize 2025؟
حقق NVARC أعلى نتيجة بنسبة 24.0% في التقييم الخاص لـ ARC-AGI-2، بمجموعة نماذج تضمنت مكونات مبنية على TRM. وجاء ARChitects ثانيًا بـ16.5% وMindsAI ثالثًا بـ12.6% (ARC Prize).