توهم مقیاسپذیری و ظهور رقیب کوچک
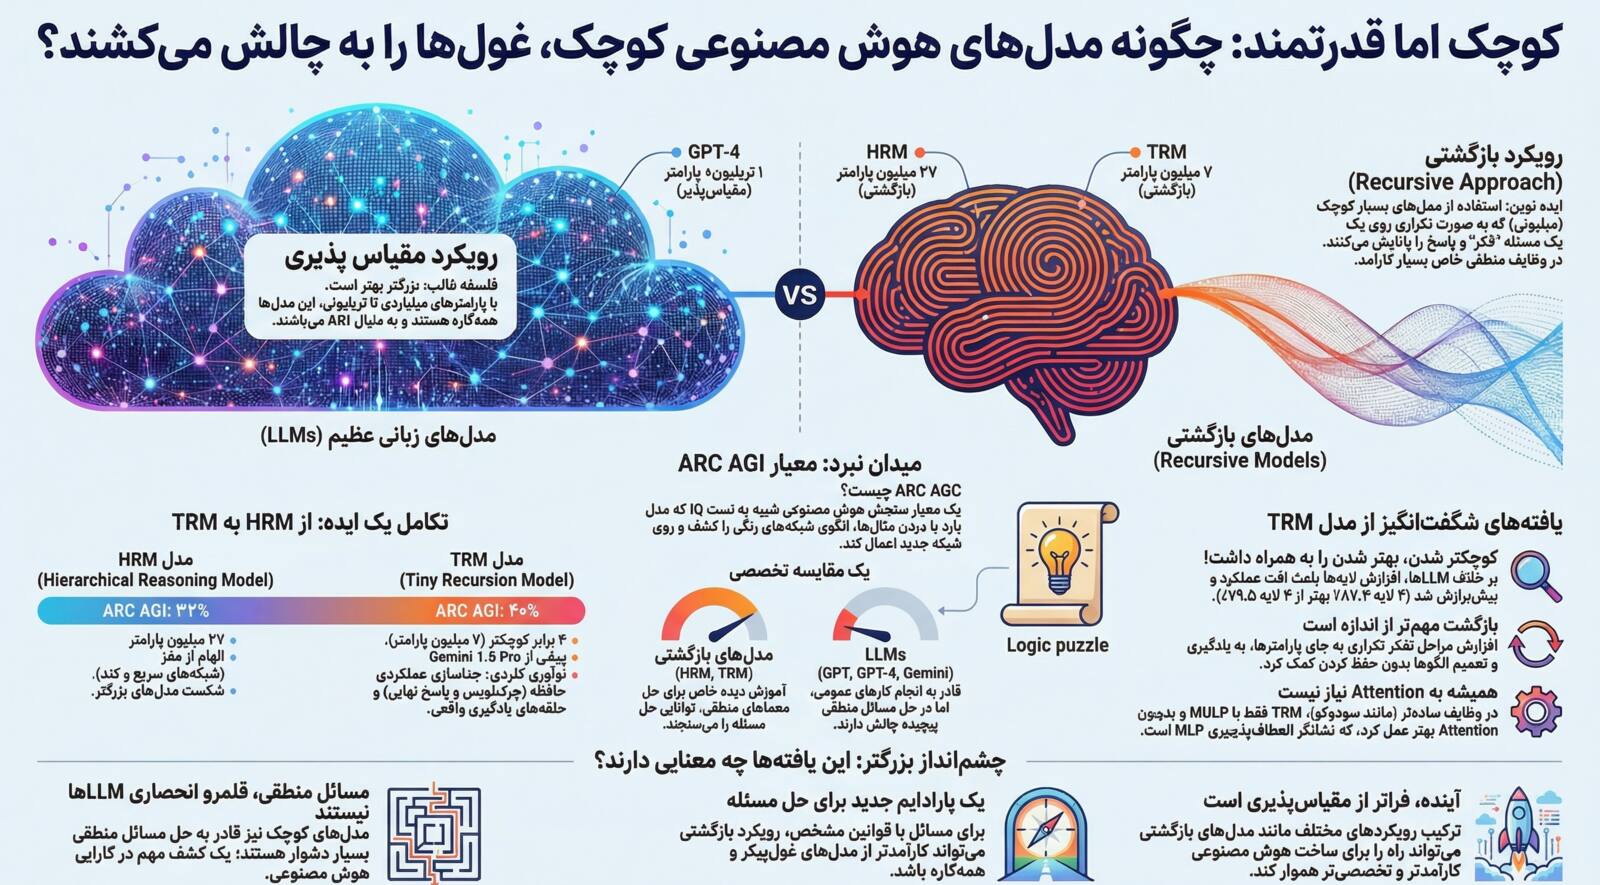
یک مدل بازگشتی با فقط ۷ میلیون پارامتر در بنچمارک استدلال ARC-AGI-1 امتیازی بالاتر از چند مدل زبانی بسیار بزرگتر گرفت، از جمله Gemini 2.5 Pro، o3-mini-high و DeepSeek R1 با ۶۷۱ میلیارد پارامتر. مدل قبلی، HRM با ۲۷ میلیون پارامتر، چند ماه زودتر نتیجهای مشابه گرفته بود. این به آن معنا نیست که مدلهای کوچک در همهچیز از مدلهای بزرگ بهترند. ولی نشان میدهد در این نوع معماهای شبکهای، اینکه یک شبکه کوچک بارها روی جواب خودش برگردد از تعداد خام پارامتر مهمتر است، آن هم با کسری از هزینه محاسباتی.
این مقاله داستان ظهور مدلهای بازگشتی کوچک (Small Recursive Models) است که قوانین بازی را تغییر دادهاند.
در حالی که مدلهای زبانی بزرگ (LLM) در حل معماهای منطقی که ما آنها را بنچمارک AGI مینامیم درجا میزنند، ایدهای جدید و جذاب در خلاف جهت این «ویروس مقیاسپذیری» شکل گرفته است. ایده ساده است: چه میشود اگر به جای بزرگ کردن مغز مدل، به آن اجازه دهیم قبل از پاسخ دادن فکر کند و جوابش را اصلاح کند؟
این ایده به HRM (مدل استدلال سلسلهمراتبی) رسید که شرکت Sapient Intelligence در ژوئن ۲۰۲۵ منتشر کرد (arXiv 2506.21734). این مدل ۲۷ میلیون پارامتر دارد و بدون پیشآموزش روی متن اینترنت، فقط با حدود ۱۰۰۰ نمونه آموزش دیده است. مقاله HRM امتیاز ۴۰٫۳٪ در ARC-AGI-1 و ۵٫۰٪ در ARC-AGI-2 گزارش میکند که در ARC-AGI-1 از o3-mini-high (۳۴٫۵٪) و Claude 3.7 8K (۲۱٫۲٪) بالاتر است. این اعداد مربوط به مجموعه ارزیابی عمومی است. وقتی تیم ARC Prize مدل HRM را روی مجموعه پنهان semi-private دوباره اجرا کرد، ۳۲٪ در ARC-AGI-1 و ۲٪ در ARC-AGI-2 ثبت شد (تحلیل ARC Prize). همان تحلیل نشان داد طراحی دوسطحی «سلسلهمراتبی» نسبت به یک ترنسفورمر معمولی هماندازه سود چندانی نداشت و بیشتر بهبود از حلقه بیرونی اصلاح جواب میآمد.
مدل HRM چطور کار میکند؟ (راز تفکر آهسته و سریع)
تفاوت اصلی اینجاست که مدلهای زبانی معمولی سعی میکنند همه چیز را در یک «گذر رو به جلو» (Forward Pass) پیشبینی کنند. یعنی تلاشی که برای محاسبه «۱+۱» میکنند برابر با تلاشی است که برای یک مسئله پیچیده صرف میکنند.
اما مدل HRM از ساختار مغز انسان الهام گرفته است. این مدل از دو شبکه ترانسفورمر کوچک تشکیل شده که با سرعتهای مختلف کار میکنند:
- شبکه سطح پایین (سریع): تغییرات جزئی و سریع روی یک «چرکنویس ذهنی» (Scratchpad) اعمال میکند.
- شبکه سطح بالا (آهسته): استراتژی کلی را تعیین میکند و تصمیم میگیرد که آیا پاسخ آماده است یا نیاز به تفکر بیشتر دارد.
این مدل به جای پاسخ آنی، به صورت بازگشتی فکر میکند و جواب خود را بارها صیقل میدهد تا به نتیجه درست برسد.
مدل TRM: وقتی «کوچک» باز هم کوچکتر میشود!
مدل سادهتر بعدی، TRM (مدل بازگشتی کوچک)، را الکسیا ژولیکور-مارتینو از Samsung SAIL Montréal در اکتبر ۲۰۲۵ معرفی کرد (arXiv 2510.04871). این مدل فرضیات بیولوژیکی HRM را کنار میگذارد، فقط از یک شبکه کوچک استفاده میکند و روش آموزش را تغییر میدهد. با ۷ میلیون پارامتر، حدود یکچهارم HRM، امتیاز بالاتری میگیرد.
مقاله TRM امتیاز ۴۴٫۶٪ در ARC-AGI-1 و ۷٫۸٪ در ARC-AGI-2 گزارش میکند (که معمولاً به ۴۵٪ و ۸٪ گرد میشود). در همان جدول، Gemini 2.5 Pro به ۳۷٫۰٪ و ۴٫۹٪، o3-mini-high به ۳۴٫۵٪ و ۳٫۰٪ و DeepSeek R1 به ۱۵٫۸٪ و ۱٫۳٪ رسیدهاند. TRM از همه جلو نیست: Grok-4-thinking امتیاز ۶۶٫۷٪ و ۱۶٫۰٪ دارد. بازآزمایی مستقل ARC Prize روی مجموعه semi-private، ۴۰٪ در ARC-AGI-1 و ۶٫۲٪ در ARC-AGI-2 را ثبت کرد (نتایج ARC Prize). نه GPT-4 و نه GPT-5 در جدول مقایسه هیچکدام از این دو مقاله نیستند.
چرا TRM موفقتر بود؟
مدل TRM به جای تقلید از مغز موش (که در HRM استفاده شده بود)، بر یک جداسازی عملکردی تمرکز کرد:
- یک فضای برای چرکنویس تفکر (Thinking Scratchpad).
- یک فضای برای پاسخ نهایی (Answer Placeholder).
این مدل به جای اینکه فرض کند به یک «تعادل» میرسد (اشتباهی که HRM داشت)، دقیقاً روی حلقههایی که اجرا میکند آموزش میبیند. جالبترین نکته اینجاست که وقتی محققان سعی کردند لایههای مدل را افزایش دهند، عملکرد آن کاهش یافت. در واقع، کوچک بودن مدل باعث شد که مدل روی دادههای محدود «Overfit» (بیشبرازش) نکند و بهتر تعمیم دهد.
آنالوژی برای درک بهتر
تصور کنید از دو نفر میخواهید یک نقاشی پیچیده بکشند.
نفر اول (یک مدل زبانی بزرگ): یک نابغه است که باید نقاشی را با یک حرکت قلم و بدون برداشتن دست از روی کاغذ تمام کند. هرچقدر هم که نابغه باشد، احتمال خطا بالاست.
نفر دوم (TRM): یک نقاش معمولی است، اما اجازه دارد طرح اولیه را بکشد، به آن نگاه کند، پاک کند، اصلاح کند و ساعتها روی جزئیات کار کند تا زمانی که از نتیجه راضی شود.
در مسائل منطقی و پیچیده، نقاش دوم (مدل بازگشتی کوچک) اغلب برنده میشود، چون فرصت فکر کردن و اصلاح دارد، حتی اگر مغز (پارامتر) کوچکتری داشته باشد.
بعدش چه شد: جایزهٔ ARC Prize 2025
TRM فقط یک کنجکاوی نماند. در نتایج ARC Prize 2025 که ۵ دسامبر ۲۰۲۵ منتشر شد، مقالهٔ «Less is More: Recursive Reasoning with Tiny Networks» مقام اول جوایز مقاله و جایزهٔ ۵۰ هزار دلاری آن را گرفت. تحلیل نتایج آن را نمونهٔ شبکههایی معرفی میکند که نسبت به عملکردشان در ARC-AGI بسیار کوچکاند و آموزش مخصوص هر مسئله را در زمان آزمون انجام میدهند.
این ایده در امتیازهای مسابقه هم دیده شد. نفر اول Kaggle یعنی NVARC با ترکیبی از مدلها که اجزای مبتنی بر TRM هم داشت، روی ارزیابی خصوصی ARC-AGI-2 به ۲۴٫۰٪ رسید و ARChitects در جایگاه دوم (۱۶٫۵٪) از اصلاح بازگشتی پاسخ روی یک مدل زبانی diffusion استفاده کرد. هیچکدام بهتنهایی یک مدل ۷ میلیون پارامتری نیستند، ولی هر دو همان حلقهای را به کار گرفتند که TRM را موفق کرد.
نتیجهگیری: آینده هوش مصنوعی بازگشتی است
این تحقیقات ثابت کرد که حل مسائل سخت منطقی تنها در انحصار مدلهای غولپیکر زبانی نیست. مدلهای کوچک با قابلیت تفکر بازگشتی (Recursion) میتوانند مسائلی را حل کنند که مدلهای بزرگ با یک بار پردازش از پس آن برنمیآیند.
این مدلها به جای حفظ کردن دادهها، یاد میگیرند که چگونه یک بوم نقاشی (Canvas) را در طی چندین مرحله ویرایش کنند تا به جواب درست برسند.
نکات کلیدی این تحقیق:
- بزرگتر همیشه بهتر نیست - معماری و روش تفکر مهمتر از اندازه است
- قابلیت بازنگری و اصلاح میتواند جایگزین میلیاردها پارامتر شود
- الهام از مغز انسان (تفکر سریع و آهسته) میتواند به مدلهای کارآمدتر منجر شود
- مدلهای کوچکتر میتوانند بهتر تعمیم دهند و کمتر دچار بیشبرازش شوند
شاید آینده هوش مصنوعی نه در مدلهای تریلیون پارامتری، بلکه در مدلهای هوشمندی باشد که میدانند چگونه «فکر کنند».
فنمایند هم دقیقاً همین شرطبندی را در مقیاس کوچکتر میزند: دستیاری محدودتر که موظف به استناد است و ترجیح میدهد رد کند تا حدس بزند، از یک دستیار گستردهتر که به همهچیز روان جواب میدهد ولی نه همیشه درست، بهتر عمل میکند. ببینید این برای یک دستیار سازمانی داخلی چطور پیش میرود.
پرسشهای متداول
مدل TRM (مدل بازگشتی کوچک) چیست؟
TRM مدلی با ۷ میلیون پارامتر است که الکسیا ژولیکور-مارتینو در Samsung SAIL مونترال در اکتبر ۲۰۲۵ منتشر کرد. این مدل بهجای پیشبینی نتیجه در یک گذر، با یک شبکهٔ کوچک چند بار روی پاسخ خودش برمیگردد و یک چرکنویس و جای پاسخ را اصلاح میکند. TRM پس از مدل ۲۷ میلیون پارامتری HRM از Sapient Intelligence آمد.
امتیاز TRM در ARC-AGI در مقایسه با مدلهای زبانی بزرگ چقدر است؟
مقالهٔ TRM امتیاز ۴۴٫۶ درصد در ARC-AGI-1 و ۷٫۸ درصد در ARC-AGI-2 را گزارش میکند، در برابر ۳۷٫۰ و ۴٫۹ درصد برای Gemini 2.5 Pro و ۱۵٫۸ و ۱٫۳ درصد برای DeepSeek R1. آزمون مستقل ARC Prize روی مجموعهٔ نیمهخصوصی ۴۰ و ۶٫۲ درصد را اندازه گرفت. Grok-4-thinking با ۶۶٫۷ و ۱۶٫۰ درصد همچنان بالاتر است.
آیا مدلهای بازگشتی کوچک از GPT-4 بهترند؟
این ادعا پشتوانه ندارد. GPT-4 و GPT-5 در جدول مقایسهٔ هیچکدام از مقالههای HRM و TRM نیستند. آنچه مقالهها نشان میدهند محدودتر است: در پازلهای شبکهای ARC-AGI، یک مدل کوچک که پاسخش را در چند دور اصلاح میکند از چند مدل زبانی بسیار بزرگتر امتیاز بیشتری میگیرد، با کسر کوچکی از توان محاسباتی.
فرق HRM و TRM چیست؟
HRM از دو شبکهٔ ترنسفورمر کوچک با سرعتهای متفاوت استفاده میکند، یکی سریع و سطح پایین و دیگری کند و سطح بالا، با الهام از مغز. TRM این فرضهای زیستی را کنار میگذارد، یک شبکه دارد و دقیقاً روی همان حلقههایی آموزش میبیند که اجرا میکند. ARC Prize دریافت بیشتر بهبود HRM از حلقهٔ اصلاح بیرونی بوده، نه از سلسلهمراتب.
آیا TRM برندهٔ ARC Prize شد؟
برندهٔ جایزهٔ اول مقاله شد. در ARC Prize 2025 مقالهٔ «Less is More: Recursive Reasoning with Tiny Networks» از الکسیا ژولیکور-مارتینو مقام اول جوایز مقاله را با جایزهٔ ۵۰ هزار دلاری گرفت. جایزهٔ امتیاز جداست و به NVARC رسید.
برندهٔ ARC Prize 2025 چه بود؟
بالاترین امتیاز را NVARC با ۲۴٫۰٪ روی ارزیابی خصوصی ARC-AGI-2 گرفت، با ترکیبی از مدلها که اجزای مبتنی بر TRM هم داشت. ARChitects با ۱۶٫۵٪ دوم و MindsAI با ۱۲٫۶٪ سوم شدند (ARC Prize).